Как использовать ИИ для парсинга
Обновлено: ноябрь 2026
Нейросети теперь могут видеть сайт глазами человека: они понимают, где на экране заголовок, где актуальная цена со скидкой, а где зачеркнутая старая стоимость — даже если у сайта самая запутанная структура.
Какой способ ИИ-парсинга выбрать под вашу задачу за 30 секунд:
- Собрать до 500 карточек без навыков программирования? Установите готовое браузерное расширение с ИИ (Thunderbit, Browse AI, Kadoa) — оно само найдет нужные колонки и выгрузит таблицу в Google Sheets за пару минут.
- Регулярно парсить один крупный сайт и не платить за каждую страницу? Попросите Claude или ChatGPT написать для вас бесплатный скрипт по образцу одной карточки товара и запускайте его на своем компьютере.
- Собирать данные с десятков сайтов с разным дизайном? Подключите автоматическое извлечение через API к быстрым и дешевым нейросетям (GPT-5.4 mini, Gemini 3.5 Flash или DeepSeek V4) в связке со сборщиком страниц (Firecrawl или Crawl4AI).
Ниже разберем, как устроен сбор данных с помощью нейросетей, какие сервисы реально экономят время и как настроить работу так, чтобы не переплачивать за воздух и не попадать под блокировки сайтов.
Два главных способа использовать ИИ в парсинге
Новички часто сливают бюджет только потому, что путают две совершенно разные роли, которые нейросеть может играть при сборе информации.
Способ 1. ИИ как бесплатный программист
Вы не заставляете нейросеть лично читать тысячи страниц. Вместо этого вы копируете фрагмент одной страницы сайта, отправляете его в обычный чат с ChatGPT или Claude и говорите: «Напиши мне программу на Python, которая вытащит отсюда название, цену и артикул». Нейросеть за 30 секунд выдает готовый скрипт. Дальше вы запускаете эту программу у себя на компьютере — она работает на высокой скорости и абсолютно бесплатно, не расходуя платные лимиты ИИ. Этот вариант идеален, когда вам нужно собрать 100 000 однотипных товаров с одного маркетплейса или каталога.
Способ 2. ИИ как умный чтец
В этом сценарии нейросеть сама читает каждую скачанную страницу и раскладывает найденные факты по полочкам вашей таблицы. Это незаменимо, когда у страниц нет единого шаблона: например, вы собираете контакты, условия доставки и имена директоров с 500 разных сайтов заводов, где информация написана обычным текстом в разделе «О компании». За чтение каждой страницы нейросеть берет небольшую плату, но взамен не ломается из-за смены дизайна сайта.
| Параметр сравнения | Обычный парсер | Скрипт, написанный через ИИ | Прямой сбор через ИИ |
| Нужно ли уметь программировать | Да, уверенный уровень | Нет, достаточно скопировать готовый код | От минимального до полного отсутствия (в сервисах) |
| Время на запуск с нуля | От 2 часов до нескольких дней | 5–15 минут | 2–10 минут |
| Что будет, если сайт сменит дизайн | Парсер сломается, нужно переписывать | Скрипт сломается, но ИИ перепишет его за 2 минуты | Продолжит работать без сбоев |
| Понимание сплошного текста без таблиц | Не умеет, ищет только по меткам кода | Не умеет | Понимает смысл и контекст |
| Стоимость обработки 10 000 страниц | $0, только расходы на прокси и сервер | $0, только расходы на прокси и сервер | От $1.50 до $12 (оплата за объем прочитанного текста) |
Как работает умный ИИ-парсер
Если вы просто скопируете ссылку на защищенный интернет-магазин, вставите ее в диалоговое окно ChatGPT и напишете «Собери все товары в таблицу», скорее всего, ничего не выйдет. Чат-бот либо ответит, что не может зайти на сайт, либо придумает несуществующие цены из головы.
Чтобы ИИ стабильно собирал данные в промышленных масштабах, процесс всегда делится на четыре последовательных шага:
- Открытие страницы и загрузка данных. Нейросеть — это мозг, который работает с текстом, но у нее нет своего полноценного браузера. Сначала специальная программа-сборщик открывает нужную ссылку, прокручивает экран вниз и ждет пару секунд, пока на странице появятся цены и отзывы, которые подгружаются не сразу.
- Очистка страницы от лишнего мусора. Обычная веб-страница внутри состоит из огромного количества технического кода: настроек цветов, шрифтов, рекламных счетчиков, меню и длинных ссылок. Если отправить все это в нейросеть целиком, вы заплатите в 10 раз больше денег за чтение бесполезного мусора, а сам ИИ может запутаться. Поэтому перед отправкой программа очищает страницу и оставляет только чистый текст со структурой заголовков — это экономит до 80–90% бюджета.
- Заполнение таблицы. Очищенный текст передается нейросети вместе с жестким шаблоном таблицы. Вы заранее указываете правила: например, в колонке «Цена» должно быть только число без значка валюты, а если телефона на странице нет — нужно оставить пустую ячейку, а не придумывать случайный номер.
- Проверка и сохранение. Готовый ответ автоматически проверяется на отсутствие повторов и сохраняется в удобном формате — Excel, Google Таблицы или базу данных.
6 лучших готовых ИИ-сервисов и расширений
Если вы маркетолог, аналитик, закупщик или продавец на маркетплейсах и не хотите открывать редактор кода, используйте готовые инструменты. Мы отобрали шесть лучших сервисов на ноябрь 2026 года, которые берут всю техническую работу на себя.
Thunderbit
Одно из самых удобных расширений для браузера Chrome, созданное специально для обычных пользователей. Вы просто открываете нужный каталог или карточку компании, нажимаете на иконку расширения и нажимаете кнопку «Предложить колонки с помощью ИИ». Нейросеть сама анализирует экран, предлагает готовую таблицу (название, цена, рейтинг, ссылка) и собирает данные.
Что умеет: переходить по страницам каталога, заходить внутрь каждой карточки товара для сбора мелких характеристик, вытаскивать таблицы из PDF-документов и картинок, а также сразу отправлять результат в Google Sheets, Notion или Airtable.
Цены: есть бесплатный пробный тариф на несколько десятков страниц, платные подписки начинаются от $15–19 в месяц в зависимости от объема проверяемых строк.
Browse AI
Визуальный сервис для тех, кому нужно не просто один раз скачать каталог, а регулярно следить за конкурентами. Вы один раз кликаете мышкой по нужным элементам на сайте, а облачный робот запоминает ваши действия и повторяет их по расписанию — например, каждое утро в 9:00 проверяет изменения цен или появление новых объявлений и присылает уведомление в Telegram или на почту.
Цены: бесплатный стартовый план на 50 кредитов в месяц, рабочие тарифы — от $19 до $48 в месяц.
Kadoa
Продвинутая платформа для бизнеса, где вообще не нужно настраивать роботов вручную. Вы вставляете ссылку на сайт, пишете обычным текстом, какие поля вам нужны, и ИИ сам строит маршрут сбора. Главная фишка Kadoa — «самовосстановление»: если сайт-источник полностью поменяет верстку, сервис сам заметит это и перестроит алгоритм без вашего участия.
Цены: есть бесплатный стартовый пакет на 500 кредитов, платные тарифы стартуют от $39 в месяц.
Firecrawl
Главный стандарт рынка в 2026 году для тех, кто настраивает автоматические связки (например, через Make или n8n) или пишет простые скрипты. Вы передаете в Firecrawl любую ссылку, а он сам обходит базовые блокировки, дожидается загрузки динамических блоков на странице и выдает либо очищенный текст, либо уже готовую заполненную таблицу по вашему описанию.
Цены: 500 страниц бесплатно при регистрации, базовый тариф Hobby стоит $16 в месяц за 3 000 страниц, тариф Standard на 100 000 страниц — $83 в месяц.
Crawl4AI
Лучший полностью бесплатный инструмент с открытым исходным кодом. Если у вас есть базовые навыки запуска скриптов на компьютере или своем сервере, Crawl4AI позволяет скачивать и очищать тысячи страниц для нейросетей без абонентской платы сторонним сервисам — вы платите только за саму нейросеть (или подключаете бесплатную локальную модель на своем компьютере).
Apify
Крупнейший облачный магазин готовых парсеров, которые внутри платформы называют «акторами». Здесь есть как универсальные ИИ-сборщики, понимающие команды на обычном языке, так и тысячи готовых шаблонов под конкретные площадки — Google Maps, Amazon, Instagram, Booking или LinkedIn.
Цены: каждому пользователю начисляется $5 на баланс ежемесячно бесплатно, платные тарифы начинаются от $29–39 в месяц по мере расхода ресурсов.
Как попросить ChatGPT или Claude написать бесплатный парсер
Когда нужно собрать 20 000 товаров с одного сайта с одинаковыми карточками, прогонять каждую страницу через платный ИИ невыгодно. Гораздо разумнее потратить 5 минут, чтобы нейросеть написала под этот сайт персональную программу-сборщик. Даже если вы никогда не программировали, разобраться не трудно:
- Откройте страницу каталога в браузере Chrome, наведите курсор мыши на название или цену первого товара, нажмите правую кнопку мыши и выберите пункт «Посмотреть код».
- Справа откроется окно с внутренним кодом сайта. Поднимитесь мышкой чуть выше по строчкам кода, пока на самом сайте синей подсветкой не выделится вся карточка товара целиком.
- Нажмите по этой строчке в коде правой кнопкой мыши, выберите Скопировать — Скопировать outerHTML.
- Откройте чат с Claude 4.5 Sonnet или GPT-5.4, вставьте скопированный кусок кода и отправьте следующий запрос:
Ты опытный разработчик парсеров на Python. Ниже я прикрепил фрагмент HTML-кода одной карточки товара с сайта.
Напиши готовый и надежный скрипт на Python (используй библиотеки requests, BeautifulSoup и pandas), который:
1. Загружает страницу каталога по указанному URL (добавь реалистичные заголовки User-Agent обычного браузера Chrome).
2. Находит все карточки товаров на странице.
3. Извлекает из каждой карточки: Название товара, Текущую цену (только число), Старую цену без скидки (если ее нет — ставит пустое значение None) и Ссылку на товар.
4. Важно: ищи данные строго внутри каждой отдельной карточки через цикл. Если какое-то поле в карточке отсутствует, скрипт не должен выдавать ошибку и останавливаться.
5. Делает случайную паузу от 2 до 4 секунд между переходом по страницам пагинации.
6. Сохраняет итоговую таблицу в файл result.xlsx.
Напиши подробную пошаговую инструкцию из 3 пунктов для новичка: какие команды ввести в терминале для установки библиотек и как запустить этот файл.
Вот код карточки:
[ВСТАВЬТЕ СКОПИРОВАННЫЙ КОД СЮДА]
Нейросеть выдаст вам полностью рабочий код и подскажет, какую одну строчку скопировать в командную строку для запуска. В результате через пару минут у вас на рабочем столе появится готовый файл Excel со всеми товарами.
Прямой сбор через ИИ
Если вы собираете данные с сотен разных сайтов, где у каждого своя верстка, писать отдельный скрипт под каждый сайт невозможно. Здесь включается прямое чтение страниц через нейросеть по API.
Главное правило экономии: никогда не используйте самые дорогие флагманские модели для простого парсинга. Чтобы вытащить цену, телефон и характеристики из текста страницы, не нужен «сверхразум» — с этим идеально справляются легкие и быстрые версии моделей, которые стоят в 15–20 раз дешевле.
Давайте посчитаем реальную стоимость обработки 1 000 страниц. После очистки от лишнего кода средняя страница интернет-магазина или статьи весит около 2 500–3 000 токенов текста, а ответ в виде таблицы занимает около 300 токенов:
- Gemini 3.5 Flash / DeepSeek V4 — самые выгодные рабочие лошадки на ноябрь 2026 года. Обработка 1 000 очищенных страниц обойдется примерно в $0.15–0.35.
- GPT-5.4 mini или GPT-4o-mini — эталон стабильности при заполнении сложных таблиц со множеством колонок. 1 000 страниц обойдутся примерно в $0.45–0.70.
- Тяжелые флагманы нужны только тогда, когда вы одновременно с парсингом просите ИИ провести сложную аналитику — например, прочитать 50 отзывов к товару, выявить главные жалобы покупателей на брак и поставить оценку продавцу. На таких моделях 1 000 страниц будут стоить $8–15.
Опытные команды используют хитрость: они объединяют обычный бесплатный скрипт и платную нейросеть в одну цепочку. Сначала страница проверяется простым бесплатным скриптом за доли секунды. Если страница стандартная и все данные нашлись — отлично, мы не потратили ни цента. А вот если сайт обновил дизайн и обычный скрипт вернул пустоту, программа автоматически пересылает текст этой страницы в нейросеть. В итоге 90% рутины разбирается бесплатно, но ваш сборщик никогда не останавливается из-за изменений на сайте.
Готовый системный промпт для точного извлечения данных
Если вы настраиваете автоматический запрос к нейросети (в Make, n8n или своем скрипте), используйте этот промпт, чтобы ИИ не придумывал лишнего:
Твоя задача — точно извлечь данные о товаре из предоставленного текста веб-страницы и вернуть ответ строго в формате JSON по заданной схеме.
КРИТИЧЕСКИЕ ПРАВИЛА:
1. Используй ТОЛЬКО факты, которые прямо указаны в тексте. Категорически запрещено угадывать, додумывать или вычислять недостающие значения.
2. Если какого-то параметра (например, артикула, скидки или бренда) нет в тексте, обязательно ставь значение null. Не пиши фразы "не указано" или "нет данных".
3. Игнорируй блоки "Похожие товары", "С этим покупают" и "Недавно просмотренные" внизу страницы — извлекай данные только по главному товару страницы.
4. Все цены приводи к чистому числовому формату без пробелов и символов валют (например: 14990.50). Валюту указывай в отдельном поле трехбуквенным кодом (USD, RUB, EUR).
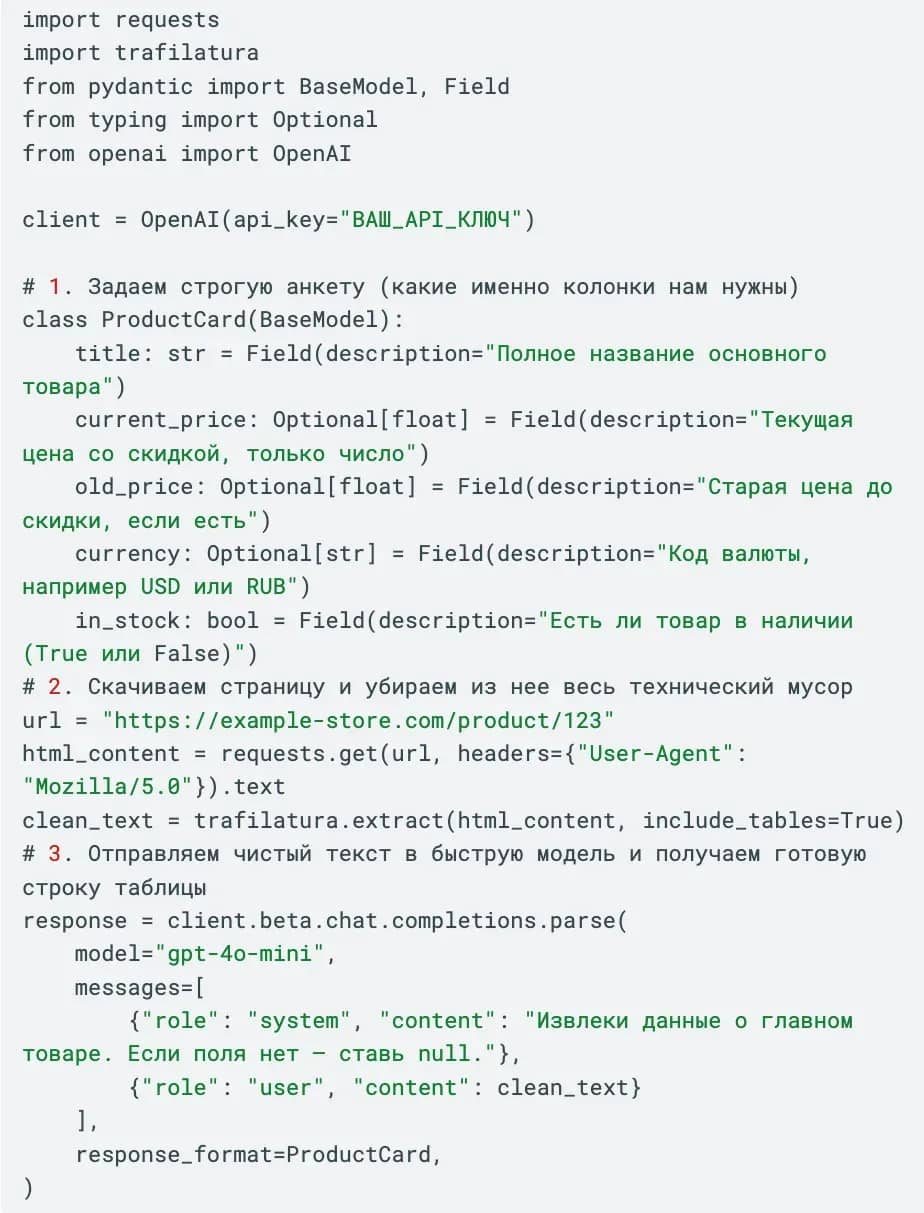
Пример простого скрипта для автоматического сбора с ИИ
Ниже показан короткий шаблон на Python, где страница сначала автоматически очищается от лишнего кода, а затем нейросеть заполняет строго заданные колонки:
Как обойти защиту сайтов: почему ИИ бессилен без прокси и правильного браузера
Настроили ИИ-парсер, проверили его на трех ссылках — все работает идеально. Вы запускаете сбор на 5 000 страниц и уходите пить чай, а через 10 минут видите, что в таблице вместо цен написано «Доступ ограничен», «Error 403» или «Подтвердите, что вы не робот».
Важно понимать: нейросеть умеет разбирать текст, но она не умеет проходить проверку безопасности сайта. Если защитная система интернет-магазина или агрегатора поняла, что к ней стучится программа, она просто не отдаст страницу, и искусственному интеллекту будет нечего читать.
Чтобы сайты отдавали данные без блокировок и бесконечных капч, нужно закрыть два уровня защиты.
Во-первых, чистые прокси. Когда с одного домашнего или офисного интернета открывается 300 страниц за минуту, любой сайт мгновенно блокирует такой адрес.
Для простых городских сайтов, небольших интернет-магазинов и открытых каталогов достаточно купить недорогие серверные или статические ISP-прокси и распределять запросы между ними.
Для крупных маркетплейсов, досок объявлений, сайтов недвижимости и авиабилетов серверные адреса не подойдут — их заблокируют на первой же странице. Здесь нужны динамические резидентские или мобильные прокси, которые автоматически меняют IP-адрес на новый домашний адрес реального провайдера при каждом запросе или каждые несколько минут.
Во-вторых, антидетект-браузер. Площадки проверяют не только ваш IP-адрес. Они смотрят на десятки параметров вашего устройства: какая видеокарта стоит в компьютере, какие шрифты установлены в системе, как именно браузер отрисовывает скрытые картинки и есть ли у вас история посещений. Обычные автоматические программы палятся на этой проверке за долю секунды.
Более того, многие ценные данные видны только после входа в личный кабинет. Если зайти в такой аккаунт через стандартного бота, профиль сразу улетит в бан.
Для решения этой задачи профессионалы запускают парсинг через профили антидетект-браузера Linken Sphere. Это работает так:
- Внутри Linken Sphere вы создаете изолированные профили, привязываете к ним чистые резидентские прокси и один раз спокойно входите в нужные аккаунты.
- Для сайта такой профиль выглядит как обычный живой покупатель, который не вызывает подозрений у систем защиты.
- После этого вы подключаете свой ИИ-сборщик или браузерного помощника напрямую к запущенному окну Linken Sphere через стандартный порт автоматизации. Браузер бережно открывает страницы без единой капчи и блокировки, а нейросеть забирает уже загруженный с экрана текст и превращает его в чистую таблицу.
Что проверить перед запуском
Чтобы не потратить токены впустую и не получить кривую таблицу, проверьте свой парсер перед массовым запуском:
- Никогда не запускайте сбор сразу на 10 000 страниц. Сначала прогоните 10–20 тестовых ссылок и глазами проверьте каждую колонку итоговой таблицы.
- Следите за обрывом длинных страниц. Если на одной странице каталога находится сразу 100 товаров, нейросеть может не уместить весь список в один ответ и просто оборвать таблицу на середине. Разбивайте длинные списки на части или собирайте товары постранично.
- Не заставляйте нейросеть считать математику во время парсинга. Не просите ИИ на лету переводить доллары в рубли по курсу, высчитывать процент скидки или складывать остатки на складах — языковые модели часто ошибаются в арифметике. Пусть ИИ просто вытащит точные цифры с сайта, а все расчеты сделает обычная формула в Excel за секунду.
- Не используйте личные аккаунты для массового сбора. Если для просмотра цен на сайте нужна авторизация, никогда не запускайте автоматический сбор со своего основного рабочего аккаунта — используйте отдельные прогретые профили в антидетект-браузере, чтобы не потерять доступ к сервису.
- Очищайте страницу от лишнего кода до отправки в ИИ. Это простое действие ускоряет работу парсера и снижает затраты на токены в десятки раз.
Часто задаваемые вопросы
- Нет, для полноценного сбора данных обычный чат не подходит по двум причинам. Во-первых, встроенный браузер чат-ботов не умеет автоматически переходить по сотням страниц каталога и блокируется защитой большинства крупных сайтов. Во-вторых, из-за ограничений памяти в обычном диалоге бот обработает максимум 10–20 позиций, после чего начнет пропускать товары или сокращать таблицу фразой «и так далее». Для реальных задач используйте браузерные расширения вроде Thunderbit и Browse AI или связку со сборщиком страниц.
- Если вам нужно один раз собрать несколько тысяч контактов или товаров с пары сайтов, готовые ИИ-сервисы обойдутся дешевле и быстрее: вы потратите до $15–20 и получите таблицу уже через полчаса, тогда как работа программиста стоит от $50–150 и занимает несколько дней. Нанимать разработчика имеет смысл только тогда, когда вам нужно ежедневно прокачивать миллионы страниц со сложной защитой в автоматическом режиме.
- Автоматический сбор открытых общедоступных данных, таких как публичные цены товаров, описания, адреса магазинов и открытая статистика, которые видны любому посетителю сайта, является стандартной рыночной практикой для аналитики и мониторинга цен. Главное правило безопасности — не собирать закрытые персональные данные частных лиц без их согласия, не копировать авторские тексты целиком для публикации на своем сайте-клоне и не создавать чрезмерную нагрузку на чужой сервер тысячами одновременных запросов в секунду.
Лучшая альтернатива OBS Studio
Работа с веб-камерой на многих онлайн-платформах превращается в испытание. На экране появляется строгий контур — овал для лица или фиксированная рамка, а ваше изображение не совпадает с ним по размеру или положению. В результате система блокирует продолжение, требуя идеального попадания, и весь процесс работы оказывается под угрозой еще до его фактического начала. Долгое время единственным решением этой проблемы был обходной путь через OBS Studio.
SOCKS и HTTP-прокси: в чём ключевые отличия и как выбрать нужный вариант
Иногда бывает важно, чтобы сайт не увидел, с какого устройства пришёл запрос. В таких случаях на сцену выходит прокси, он становится прослойкой между вами и сайтом, берёт запрос на себя и отправляет его от своего имени. Сайт получает информацию не о вас, а о прокси. Это рабочий приём, когда нужно открыть страницу, заблокированную в вашем регионе, получить доступ к контенту с геозамками или не упереться в лимит, если отправляете много запросов подряд.
Почему Google блокирует аккаунты и при чем здесь ваш антидетект
Google в очередной раз усложнил механизмы цифровой идентификации, развернув новый, более сложный уровень защиты, основанный на проприетарных HTTP-заголовках. Это тихое изменение застало большую часть рынка врасплох, вызвав волну поспешных обновлений. Пока остальные спешно выпускали поверхностные «фиксы», мы поняли, что столкнулись не с мелкой проблемой, а с принципиальным сдвигом, требующим глубокого и всестороннего анализа.